BNP Paribas · Crédit Agricole · Olivier Assurance
Règles d'éligibilité et calcul de mensualité sur le crédit à la consommation, outil de profiling et scoring par forêt aléatoire, reporting métier et optimisation d'espaces.
S2A est dirigé par Samuel Kaci, data scientist formé aux mathématiques appliquées. Recherche universitaire, banque, assurance, santé, presse : les systèmes que nous construisons s'appuient sur un parcours mené dans des environnements où l'erreur coûte cher.
Aucun intermédiaire commercial. La personne qui cadre votre mission est celle qui la conduit, la met en production et l'exploite ensuite.
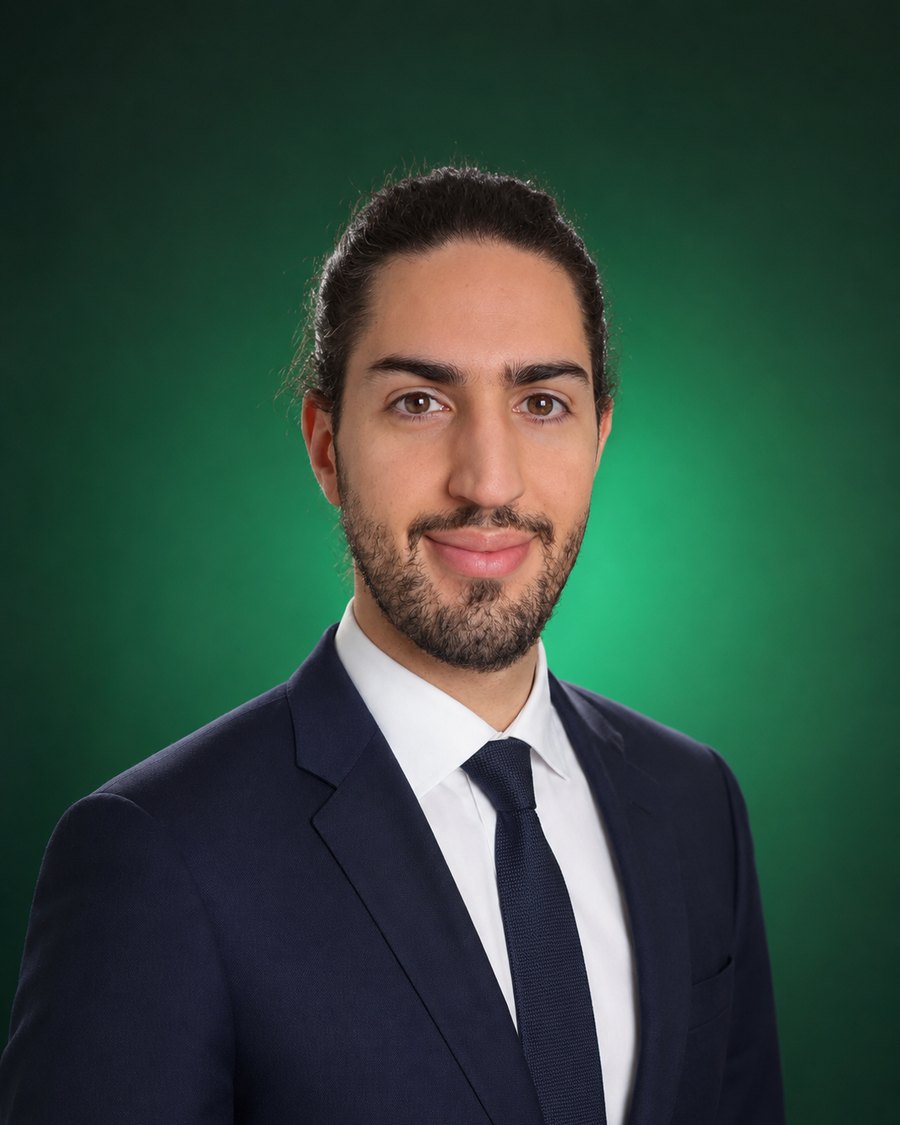
Mathématicien de formation : licence de mathématiques fondamentales et appliquées à Montpellier, spécialisation probabilités et statistiques, puis deux masters — SIAD, statistiques pour l'information et l'aide à la décision, et MIND, mathématiques de l'information et de la décision.
Le parcours commence par la recherche. À l'IMAG, laboratoire de l'Université de Montpellier et du CNRS, sur les tests d'adéquation à la loi de Newcomb-Benford — l'outil statistique qui sert à détecter la fraude. Objectif : construire un test plus puissant que ceux qui existaient. Puis au CHU de Montpellier, sur l'algorithme qui apparie un greffon à un patient en attente de greffe.
Vient ensuite l'industrie. Les règles d'éligibilité et le calcul de mensualité du crédit à la consommation chez BNP Paribas. Un outil de profiling et de scoring par forêt aléatoire au Crédit Agricole. Le reporting métier chez Olivier Assurance. Le text mining et l'aide à la décision chez SaorIA. Puis les chaînes d'automatisation documentaire et les assistants métiers fondés sur des modèles de langage.
S2A est né de ce que ce parcours a rendu évident : ce qui manque rarement, c'est le modèle. Ce qui manque, c'est le système qui tourne tous les jours, que quelqu'un maintient, et dont on peut expliquer chaque sortie.
Des secteurs où la donnée engage une responsabilité : un crédit accordé, un greffon attribué, une annonce légale publiée. C'est cette exigence que nous appliquons à vos processus.
Règles d'éligibilité et calcul de mensualité sur le crédit à la consommation, outil de profiling et scoring par forêt aléatoire, reporting métier et optimisation d'espaces.
Amélioration de l'algorithme d'appariement entre greffons et patients en attente, et conduite d'une étude statistique sur les greffés du foie en France.
Travaux sur les tests d'adéquation à la loi de Newcomb-Benford, appliqués à la détection de fraude. Construction d'un test statistique plus puissant que l'existant.
Chaîne complète d'automatisation des demandes d'annonces légales : lecture des courriels, extraction par IA, génération de l'annonce et flux de facturation.
Missions de data scientist et de lead data scientist : pilotage de projets data, référent technique, garant des méthodologies et arbitrage des choix d'architecture.
Aide à la décision sur les évolutions politico-juridiques : text mining, analyse descriptive et prédictive, amélioration de la pertinence des algorithmes.
Des technologies standard, choisies pour la tâche. Un prestataire tiers doit pouvoir reprendre ce que nous construisons.
R en usage expert : manipulation, dataviz avancée, applications Shiny, modélisation, industrialisation de workflows.
Classification, régression, scoring, segmentation, réseaux de neurones, méthodes ensemblistes — et l'évaluation qui va avec.
Préparation, orchestration, flux d'intégration, tableaux de bord interactifs et reporting automatisé.
Hébergement, déploiement et exploitation des solutions data, avec intégration continue et reproductibilité des traitements.
Une part importante de ce qui rate dans les projets data tient à des erreurs de méthode : un modèle validé sur les mauvaises données, un indicateur qui ne mesure pas ce qu'on croit, une conclusion tirée d'un écart non significatif.
C'est pourquoi le socle est mathématique avant d'être technologique. Les outils changent tous les trois ans. La rigueur statistique, elle, ne se périme pas.
Deux options s'offrent habituellement aux organisations qui veulent automatiser : acheter une plateforme générique et passer des mois à s'y plier, ou lancer un projet de transformation dont le coût dissuade avant le démarrage.
Nous occupons l'espace entre les deux : un périmètre net, un système construit autour du processus réel, une mise en production rapide, puis une extension progressive. La valeur d'une automatisation se mesure à ce qu'elle libère, pas à son ampleur.
Architecture documentée, technologies standard, réversibilité, coût d'exploitation annoncé : les standards d'un grand cabinet, appliqués là où ils font la différence.